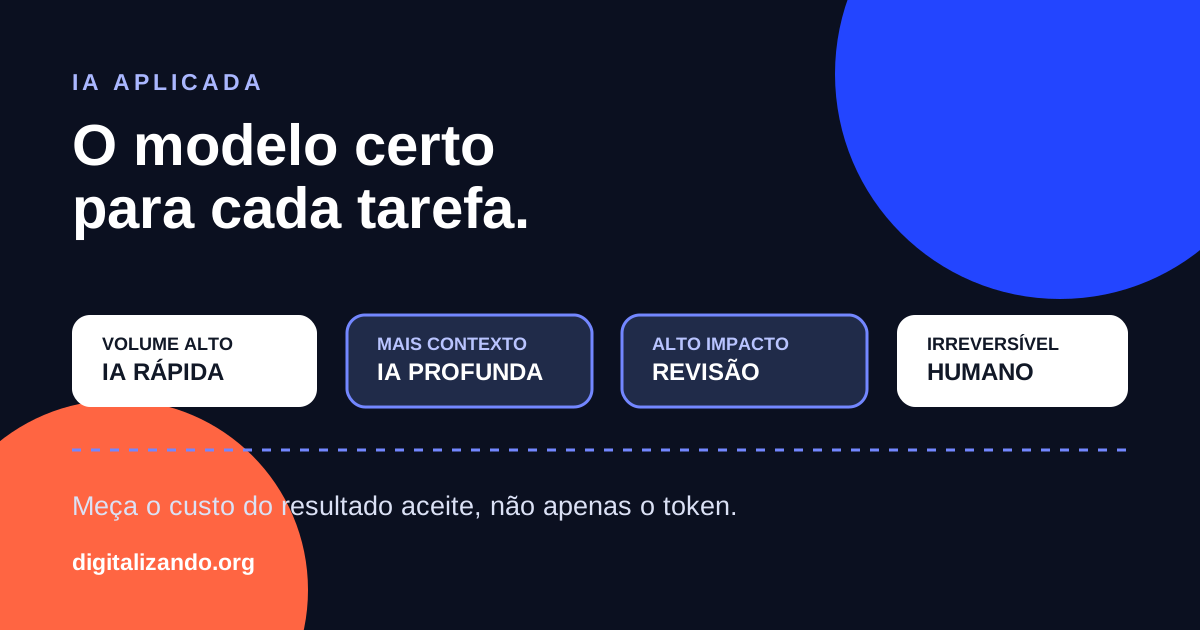
Na mesma manhã, uma empresa pode precisar de classificar quinhentos pedidos, comparar duas propostas de fornecedores e decidir se aceita uma condição de pagamento fora do habitual.
As três tarefas podem envolver inteligência artificial. Isso não significa que devam usar o mesmo modelo, o mesmo nível de raciocínio ou o mesmo grau de autonomia.
O seletor de modelos cria uma tentação compreensível: escolher “o melhor” e usá-lo para tudo. Em produção, esta decisão costuma ser cara e pouco informativa. Um modelo muito capaz pode estar a gastar tempo em trabalho previsível. Um modelo rápido pode produzir uma resposta plausível numa tarefa em que um erro custa demasiado.
A 2 de outubro de 2026, a OpenAI publicou um guia para a família GPT‑6 que recomenda ajustar modelo, esforço de raciocínio e velocidade ao tipo de trabalho. O princípio interessa mesmo a quem usa outros fornecedores: a escolha deve começar na tarefa, não no nome do modelo.
Comece por quatro características do trabalho
Antes de comparar preços, descreva a tarefa com quatro perguntas:
- Qual é o impacto de um erro? Uma etiqueta errada pode ser corrigida. Um desconto enviado ao cliente já produz uma consequência.
- É fácil verificar a resposta? Extrair um NIF tem uma resposta objetiva. Avaliar a qualidade de uma proposta exige mais julgamento.
- Qual é o volume? Uma tarefa repetida dez mil vezes amplifica pequenas diferenças de custo e latência.
- Quanto contexto é necessário? Classificar uma frase é diferente de cruzar contratos, histórico comercial e regras internas.
Esta descrição já evita dois erros: pagar capacidade que a tarefa não usa e poupar precisamente onde uma falha seria mais cara.
Quatro destinos possíveis para uma tarefa
| Tipo de trabalho | Exemplo | Escolha inicial | Controlo |
|---|---|---|---|
| Repetitivo e verificável | Extrair campos de faturas | Modelo rápido, raciocínio baixo | Amostra e regras automáticas |
| Variável, mas reversível | Preparar um resumo comercial | Modelo equilibrado, raciocínio médio | Revisão por exceção |
| Complexo e de maior impacto | Comparar condições contratuais | Modelo mais capaz, raciocínio alto | Validação especializada |
| Sensível ou difícil de reverter | Alterar IBAN ou autorizar pagamento | IA pode preparar evidência | Decisão e execução humanas |
O guia da OpenAI dá exemplos semelhantes: GPT‑6 Luna para tarefas focadas e repetidas com objetivo claro, GPT‑6.1 Sol para investigação, programação e utilização de computador mais complexas, e GPT‑6 Astra para o raciocínio mais exigente. Também propõe aumentar o esforço de raciocínio apenas quando a melhoria justificar o custo e o tempo adicionais.
Isto não deve ser lido como uma tabela universal. É uma hipótese de encaminhamento que precisa de ser testada com casos reais da empresa.
Preço por token não é custo do trabalho
Uma resposta barata que exige quinze minutos de correção pode custar mais do que uma resposta mais cara aceite quase sem alterações. A conta útil inclui o fluxo completo:
custo por resultado aceite = uso do modelo + tempo de revisão + correções + tratamento de exceções
Imagine, de forma ilustrativa, um processo de triagem de pedidos. O modelo A custa menos por execução, mas a equipa corrige um em cada quatro resultados. O modelo B custa mais, mas quase todas as saídas seguem sem alteração. Sem medir o tempo de revisão, a empresa pode escolher o modelo aparentemente económico e aumentar o custo humano do processo.
O mesmo vale para velocidade. Uma resposta em dois segundos pode ser decisiva numa conversa com o cliente. Num relatório noturno, alguns segundos adicionais talvez não tenham valor económico.
Um exemplo: tratar pedidos de orçamento
Considere uma caixa de entrada que recebe pedidos em texto livre, PDFs e fotografias. É possível separar o trabalho em camadas:
- um modelo rápido identifica cliente, produtos, quantidades e campos em falta;
- regras verificam formatos, valores obrigatórios e duplicados;
- um modelo mais capaz prepara o resumo quando existe informação contraditória ou linguagem ambígua;
- uma pessoa decide descontos, prazos especiais e compromissos comerciais;
- o sistema regista a origem, a versão final e as correções.
A empresa deixa de discutir qual modelo “vence” em abstrato. Passa a decidir que parte do trabalho cada nível de capacidade deve receber.
Teste com casos representativos
Escolha uma tarefa e reúna trinta casos reais, retirando dados pessoais quando possível. Inclua casos simples, ambíguos e excecionais. Defina antes do teste o que conta como resposta aceite.
Compare duas ou três configurações e registe:
- percentagem aceite sem alteração;
- minutos de revisão e correção;
- latência;
- custo total por resultado aceite;
- tipos de erro;
- casos que deveriam ter sido encaminhados para uma pessoa.
A dimensão da amostra não prova desempenho universal. Serve para revelar se a configuração funciona no trabalho observado e onde ainda falha.
Contexto repetido também tem custo
Em tarefas recorrentes, a empresa costuma enviar as mesmas instruções, políticas e exemplos em cada pedido. O guia publicado pela OpenAI refere que entradas reutilizadas através de cache podem custar até 95% menos do que entradas não armazenadas, dependendo do modelo.
Isso só funciona bem quando o contexto está organizado. Instruções estáveis, fontes aprovadas e definições consistentes devem aparecer antes da parte variável. Se cada execução recompõe tudo de maneira diferente, a empresa perde previsibilidade e também a possibilidade de reutilizar contexto.
A decisão que fica para a próxima semana
Escolha uma tarefa de volume suficiente para medir. Escreva quatro linhas: impacto do erro, facilidade de verificação, contexto necessário e tempo aceitável. Depois teste duas configurações com os mesmos casos.
O critério não é “qual respondeu melhor uma vez”. É qual produziu mais resultados aceites, com risco controlado e menor custo total.
O guia Como calcular o retorno de uma automação? ajuda a transformar tempo, correções e valor numa conta comparável. Para descrever a tarefa antes do teste, pode usar a ficha de processo pública do Negócio Digital na Prática. O kit completo continua com compras em preparação; a amostra é pública e utilizável.